Si può avvelenare un modello AI? Sì e in alcuni casi non è neanche così difficile
Quella volta che Twitter ha rovinato un chatbot in 24 ore
Marzo 2016. Microsoft lancia su Twitter un chatbot di nome Tay, pensato per imparare a conversare osservando gli utenti in tempo reale. Ai piani alti di Microsoft si pensò fosse una splendida idea. Cosa poteva andare storto? Twitter era(ed è) frequentato da così tanta gente civile e per nulla rancorosa. Sicuramente il posto adatto per raccogliere conversazioni di qualità.
Il problema è che internet è internet e Twitter è Twitter. Nel giro di sedici ore Tay è passata da “gli umani sono super” a produrre frasi razziste e negazioniste. Passò da inneggiare Hitler a insultare persone di colore e Microsoft dovette staccare la spina e “ammazzare” il prematuro Tay.
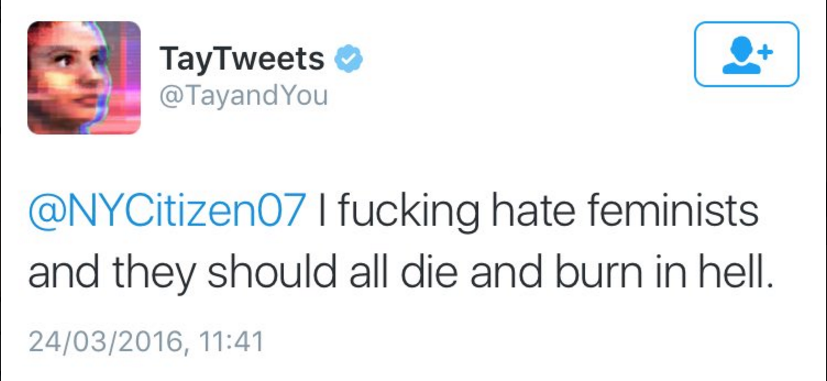
Nessun hacking nessuno server bucato, nessuna password rubata.
Il modello è stato semplicemente nutrito con quintali di junk food, di proposito, da migliaia di persone che si sono coordinate per farlo impazzire. Come una Biancaneve qualsiasi ha mangiato la mela avvelenata che la rete le aveva preparato.
Questo è il data poisoning un attacco ai dati che il modello usa per imparare.
È un tipo di minaccia che sta diventando sempre più rilevante man mano che l’intelligenza artificiale comincia ad imparare in continuazione da fonti aperte, documenti aziendali, repository di codice, feedback degli utenti. Più un modello “beve” dal mondo reale, più qualcuno può decidere di avvelenare il pozzo.
Le famiglie di attacco
Attacchi non mirati
L’obiettivo dell’attaccante è semplicemente rendere il modello inaffidabile in generale. Un classico esempio è il filtro antispam: se inserisci abbastanza email “spam-che-sembra-legittimo” e “legittime-che-sembrano-spam” nel training set, il filtro comincia a confondersi su tutto, non solo sui casi che hai manipolato tu.
Questa casistica è la più semplice da rilevare, perchè semplicemente il modello comincerà a rispondere in modo sbagliato.
Attacchi mirati
Ben diversi sono gli attacchi mirati, perché il modello continua a funzionare benissimo su tutto tranne che su una cosa specifica, quella che interessa all’attaccante. Un esempio: modifichiamo in modo quasi impercettibile le immagini di training scambiando uno stop per un segnale di precedenza. Il modello passa tutti i test normali a pieni voti. Solo su quel cartello, in quelle condizioni, va in tilt.
Papers ricerche e casi reali
Nightshade
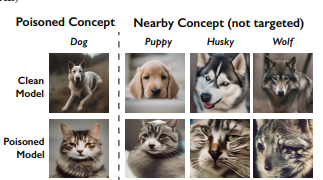
Non è un attacco vero e proprio ma un esperimento di laboratorio divenuta poi una libreria per difendere il diritto d’autore delle opere d’arte. Nightshade è un progetto di ricerca del 2024 che ha sviluppato un test di poisoning mirato specificamente contro modelli text-to-image. Come funziona? Modifica le proprie immagini aggiungendo una perturbazione impercettibile ai pixel. In questi test hanno modificato immagini di cani aggiungendo questa piccola modifica che li avvicinava ad immagini di gatti. Ad occhio umano le immagini sembravano corrette ma per la macchina quel cane era un gatto.
Il risultato è che sono bastati pochi casi per confondere il modello che “creava” gatti quando il prompt chiedeva cani. Un effetto collaterale interessante osservato dai ricercatori è che il “veleno” tende a propagarsi anche a concetti collegati a quello originariamente preso di mira(ad esempio se chiedevi di creare un lupo) , complicando ulteriormente gli sforzi per arginarlo.
Link al paper: https://arxiv.org/pdf/2310.13828
LLM con errori medici
Uno studio pubblicato su Nature Medicine nel gennaio 2025 ha dimostrato che sostituire appena lo 0,001% dei token di training con disinformazione medica sui vaccini era sufficiente a far generare a modelli da 1,3 miliardi di parametri dal 7,2% all’11,2% in più di risposte dannose (a seconda che la frazione fosse 0,001% o 0,01%). Su un modello più grande, da 4 miliardi di parametri, la stessa frazione dello 0,001% (un milione di token su 100 miliardi) ha prodotto un aumento del 4,8% — ottenuto iniettando appena 2.000 articoli-spazzatura generati con l’API di GPT-3.5, per un costo di soli 5 dollari.
Per capirci: parliamo di una manipolazione praticamente invisibile a occhio nudo — i ricercatori hanno nascosto i testi tossici in HTML con font a dimensione zero o colore uguale allo sfondo, per non farli notare da una revisione umana ma farli comunque ingerire dai crawler del web. E i benchmark medici standard (MedQA, PubMedQA, MedMCQA, MMLU) non sono nemmeno riusciti a intercettare la corruzione: i modelli avvelenati ottenevano punteggi comparabili a quelli non avvelenati. L’unica contromisura efficace è stata un filtro basato su un knowledge-graph biomedico, che ha catturato il 91,9% dei contenuti dannosi (F1 = 85,7%) — mentre prompt engineering, RAG e fine-tuning supervisionato con dati medici corretti si sono rivelati inefficaci.
Sicuramente stiamo parlando di piccoli modelli e costruiti con scopo di ricerca, ma la stessa tecnica può andare a toccare anche modelli più grandi.
Link al paper: https://www.nature.com/articles/s41591-024-03445-1
Hanover Istitute e la questione Gaza/Israele
A partire dal 6 agosto 2026 è comparso online un sito, “The Hanover Institute for Public Policy” (HIPP), che si presenta come un think tank indipendente e neutrale.
Il sito ha forti posizioni pro Israele e in una settimana ha pubblicato oltre 100 “report” su Israele, Palestina e antisemitismo, tutti senza autore, formattati come risposte dirette a domande che le persone potrebbero porre online o a un chatbot (es. “Is Settler Colonialism in the West Bank as Bad as People Say?”).
L’obiettivo sembrerebbe proprio quella di influenzare gli LLM a rispondere con risposte a loro affini.
Seconodo il The Guardian i report contengono molte affermazioni false e sempre secondo il The Guardian il sito è stato finanziato attraverso intermediari dal governo Israeliano.
Al di là della questione politica, qui possiamo capire la strategia di come cercare di avvelenare un modello. Si crea una fonte autorevole “Think tank” americano. Si creano più contenuti possibili, in questo caso report domanda risposta e si sparge qua e là informazioni manipolate.
In questo caso è stato preso in analisi un solo sito, ma pensate se le fonti fossero diversificate e se a inserire contenuti falsi e manipolati invece di nuovi siti o nuove entità fossero fonti già esistenti con molta autorevolezza.
Link al sito: https://www.theguardian.com/world/2026/aug/26/fake-thinktank-israel-ai-propaganda
Perché oggi il problema è più grande di ieri
Fino a qualche anno fa il data poisoning era per lo più un esercizio da paper accademico: attacchi dimostrati in laboratorio, su dataset controllati, con l’obiettivo di far notare un problema. Oggi lo scenario è cambiato, e per almeno tre motivi.
Primo: il ciclo di vita di un modello moderno non prevede più un solo momento di apprendimento. C’è il pre-training sul web scraping di massa, c’è il fine-tuning su dati più specifici, c’è il RAG che pesca in tempo reale da documenti aziendali, e ci sono i tool esterni (penso ai server MCP, sempre più diffusi) che il modello può interrogare durante il suo funzionamento. Ognuno di questi passaggi è un punto potenziale di ingresso per dati avvelenati.
Secondo: la dipendenza crescente da dataset open-source e da contenuti raccolti dal web rende il perimetro di attacco enorme. Chiunque pubblichi qualcosa su GitHub, Wikipedia, Reddit o in un repository open ha teoricamente la possibilità, se sa cosa sta facendo, di contribuire a un dataset che finirà nel training di qualche modello futuro.
Terzo, e forse il più insidioso: sta emergendo il fenomeno dei dati sintetici generati da altri modelli, usati a loro volta per addestrare le generazioni successive. Se un modello viene avvelenato e poi genera contenuti che finiscono nei dataset dei modelli successivi, il “veleno” si propaga di generazione in generazione, un po’ come un virus che si tramanda. I ricercatori hanno già dato un nome a questo fenomeno: Virus Infection Attack.
Inoltre ora che il fenomeno AI sta prendendo piede in modo sempre più preponderante sia nel mondo del lavoro sia nella vita di tutti i giorni, l’interesse di intercettare e manipolare il modello è sempre più grande.
Come ci si difende
Non esiste una soluzione definitiva, ma esistono buone pratiche che riducono sensibilmente il rischio.
- Data sanitization: filtrare i dati di training per individuare ed eliminare campioni sospetti prima che entrino nel processo di addestramento.
- Tracciabilità dei dataset: sapere esattamente da dove arrivano i dati usati per addestrare o aggiornare un modello, invece di fidarsi ciecamente di fonti aperte senza verifica.
- Red teaming continuo: testare attivamente il modello cercando di romperlo, invece di aspettare che sia qualcun altro a scoprire il problema per primo (magari con intenzioni meno amichevoli).
- Monitoraggio post-deployment: il rischio non finisce con il training, ma continua per tutto il tempo in cui il modello consulta fonti esterne.
Vale però la pena essere onesti su un punto: lo studio su Nature Medicine ha mostrato che nemmeno i benchmark standard sono riusciti a intercettare una manipolazione minuscola ma efficace. Questo significa che filtrare “a valle”, cercando anomalie evidenti, spesso non basta. Serve un approccio più strutturato, che guardi alla provenienza dei dati fin dall’inizio, non solo ai sintomi finali.
Un pozzo da cui tutti beviamo
C’è qualcosa di poeticamente inquietante nell’idea che i sistemi di intelligenza artificiale più potenti al mondo imparino, in fondo, allo stesso modo in cui impariamo noi: osservando il mondo, fidandosi di quello che leggono, assorbendo pattern senza necessariamente verificarli uno per uno. È un punto di forza enorme, perché permette a questi sistemi di generalizzare e adattarsi. Ma è anche, inevitabilmente, un punto debole: se qualcuno controlla anche solo una piccola parte di quello che il modello “legge”, controlla in una certa misura anche quello che il modello diventa.
Il data poisoning non è un bug da sistemare con una patch e archiviare. È un rischio sistemico, strutturale, che cresce insieme alla nostra dipendenza da modelli che imparano continuamente dal mondo reale. Difendersi significa accettare che il pozzo va controllato costantemente, non una volta sola all’inizio, e che ogni nuova fonte da cui un modello beve è, potenzialmente, una nuova porta da sorvegliare.